admin
# app/logger.py — Set up structured logging
import logging
import json
from datetime import datetime

class StructuredLogger:
    def __init__(self, name, **default_context):
        self.logger = logging.getLogger(name)
        self.default_context = default_context

    def _log(self, level, message, **context):
        """Log in structured JSON format"""
        log_entry = {
            "timestamp": datetime.utcnow().isoformat(),
            "level": level,
            "message": message,
            **self.default_context,
            **context
        }
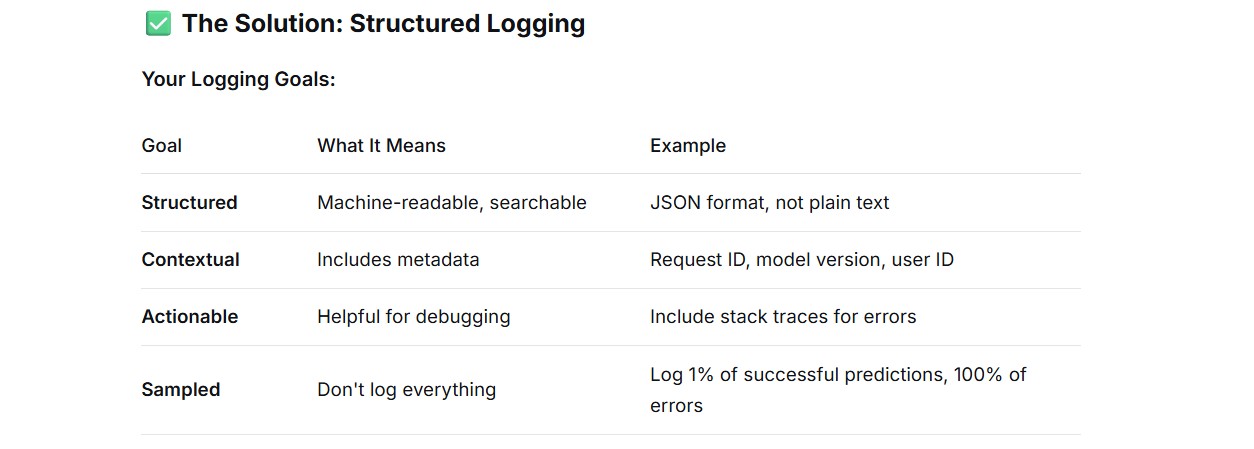
        # Print JSON to stdout (Cloud Logging picks it up)
        print(json.dumps(log_entry))

    def info(self, message, **context):
        self._log("INFO", message, **context)

    def error(self, message, **context):
        self._log("ERROR", message, **context)

    def warning(self, message, **context):
        self._log("WARNING", message, **context)

# Create a global logger with default context
logger = StructuredLogger(
    "model-api",
    service="churn-model-api",
    environment=os.environ.get("ENVIRONMENT", "development")
)
# app/predict.py
from app.logger import logger
import os

def predict(features, request_id):
    """Make a prediction with logging"""

    # Log incoming request
    logger.info(
        "Prediction request received",
        request_id=request_id,
        feature_count=len(features),
        model_version=os.environ.get("MODEL_VERSION", "unknown")
    )

    try:
        # Load model and predict
        model = load_model()
        start_time = time.time()
        result = model.predict(features)
        inference_time = time.time() - start_time

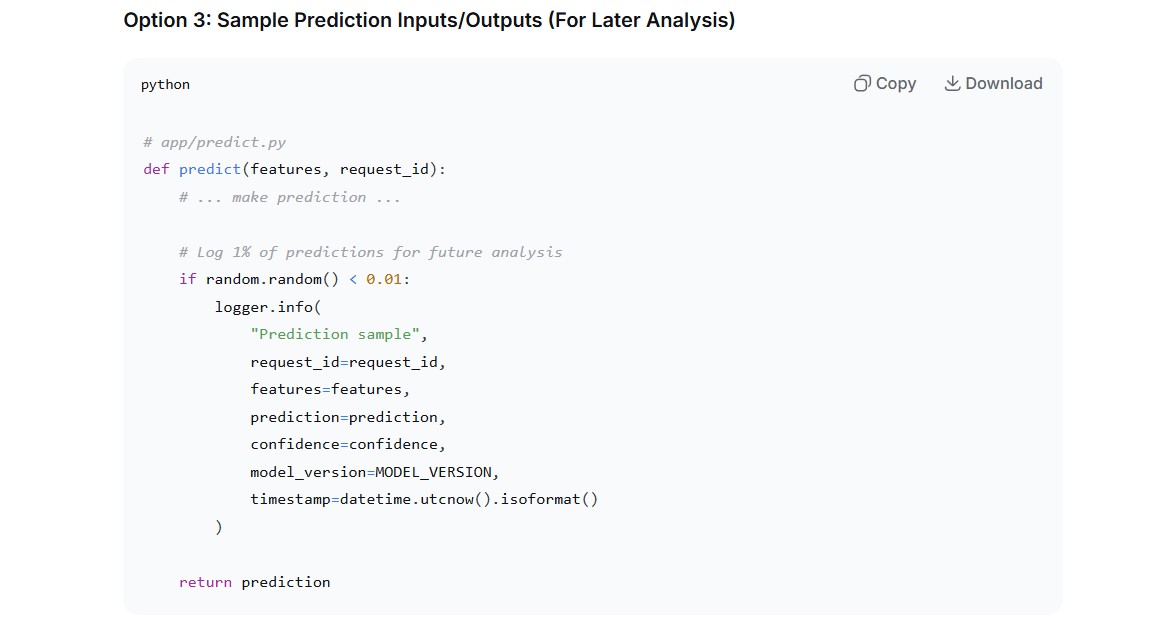
        # Log successful prediction (sampled)
        if random.random() < 0.1:  # 10% sample rate
            logger.info(
                "Prediction successful",
                request_id=request_id,
                inference_time_ms=inference_time * 1000,
                prediction=result,  # Only if non-sensitive
                confidence=max(result) if hasattr(result, 'max') else None
            )

        return result

    except Exception as e:
        # Always log errors with full context
        logger.error(
            "Prediction failed",
            request_id=request_id,
            error_type=type(e).__name__,
            error_message=str(e),
            stack_trace=traceback.format_exc(),
            feature_preview=features[:5]  # Preview of input
        )
        raise
from google.cloud import monitoring_v3

def create_prediction_metric(value, model_version, confidence):
    """Send custom metric to Cloud Monitoring"""

    client = monitoring_v3.MetricServiceClient()
    project = f"projects/{os.environ.get('GOOGLE_CLOUD_PROJECT')}"

    # Create a time series
    series = monitoring_v3.TimeSeries()
    series.metric.type = "custom.googleapis.com/model/prediction_confidence"

    # Add labels for filtering
    series.metric.labels["model_version"] = model_version
    series.metric.labels["environment"] = os.environ.get("ENVIRONMENT", "dev")

    # Add data point
    point = monitoring_v3.Point()
    point.value.double_value = confidence
    point.interval.end_time = time.time()
    point.interval.start_time = time.time()

    series.points = [point]

    # Send to Cloud Monitoring
    client.create_time_series(name=project, time_series=[series])
# app/monitoring/ml_monitor.py
import numpy as np
from scipy.stats import ks_2samp
import pandas as pd

class MLModelMonitor:
    def __init__(self, training_data_stats, threshold=0.05):
        self.training_stats = training_data_stats
        self.threshold = threshold

    def check_data_drift(self, features):
        """Check for data drift using Kolmogorov-Smirnov test"""
        drift_detected = []

        for feature_name, value in features.items():
            # Compare to training distribution
            train_dist = self.training_stats[feature_name]
            test_dist = value

            # Perform KS test
            statistic, p_value = ks_2samp(train_dist, [test_dist])

            if p_value < self.threshold:
                drift_detected.append({
                    "feature": feature_name,
                    "p_value": p_value,
                    "statistic": statistic
                })

        if drift_detected:
            logger.warning(
                "Data drift detected",
                drift_metrics=drift_detected,
                model_version=os.environ.get("MODEL_VERSION")
            )

        return drift_detected

# Use in prediction endpoint
def predict(features, request_id):
    monitor = MLModelMonitor(training_stats)
    drift = monitor.check_data_drift(features)

    if drift:
        # Log drift metrics
        logger.warning("Data drift detected", request_id=request_id, drift=drift)

    # Still make prediction
    result = model.predict(features)
    return result
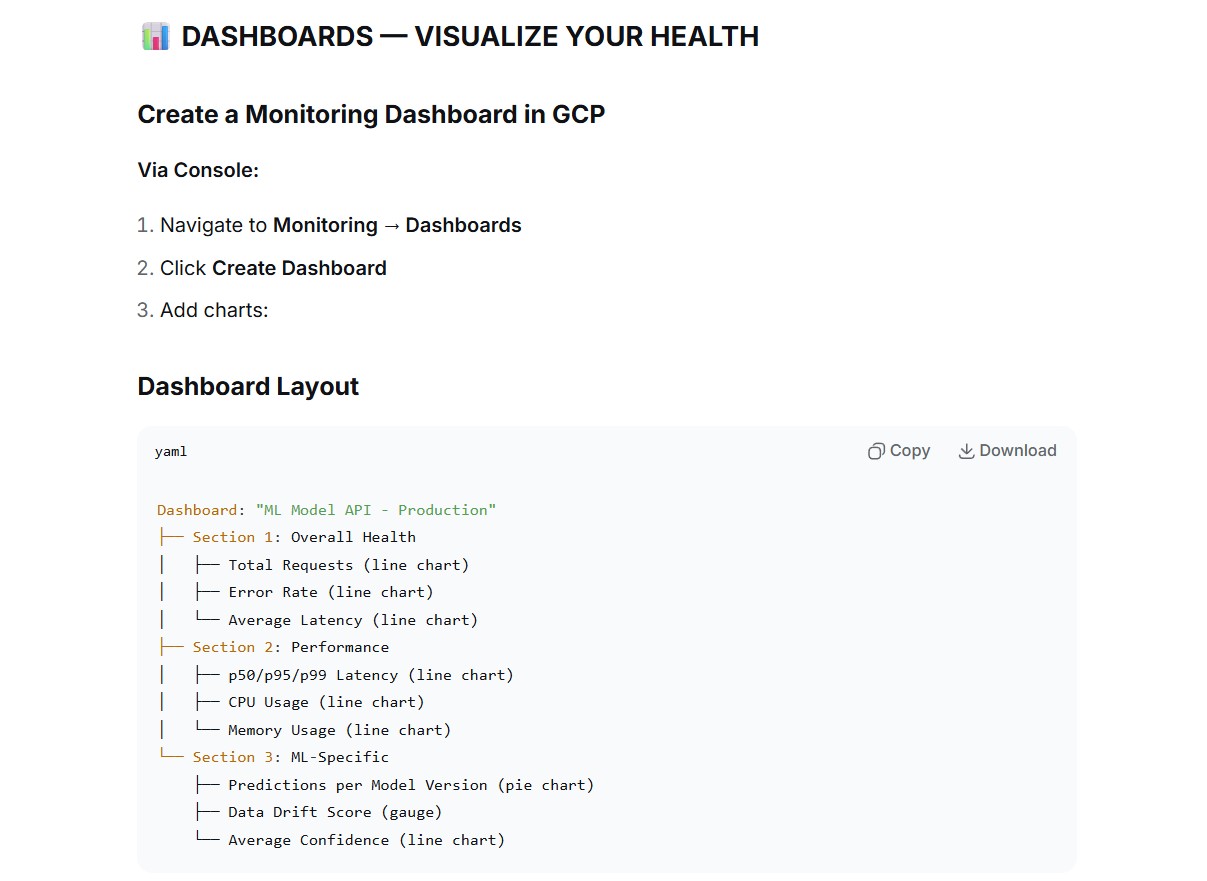
displayName: "ML Model API - Production"
widgets:
  - xyChart:
      dataSets:
        - timeSeriesQuery:
            timeSeriesFilter:
              filter: |
                metric.type="run.googleapis.com/request_count"
                resource.type="cloud_run_revision"
                resource.labels.service_name="churn-model-api"
          displayName: "Request Count"
      timeshiftDuration: "86400s"
      yAxis: {label: "Requests"}
  - xyChart:
      dataSets:
        - timeSeriesQuery:
            timeSeriesFilter:
              filter: |
                metric.type="run.googleapis.com/request_latencies"
                resource.type="cloud_run_revision"
                resource.labels.service_name="churn-model-api"
                metric.labels.response_code_class="2xx"
          displayName: "Latency (p95)"
      timeshiftDuration: "86400s"
      yAxis: {label: "Latency (ms)"}
  - scorecard:
      timeSeriesQuery:
        timeSeriesFilter:
          filter: |
            metric.type="custom.googleapis.com/model/prediction_confidence"
            resource.type="global"
      displayName: "Avg Model Confidence"
# 1. Request comes in
{
    "request_id": "req-abc-123",
    "features": [1.2, 3.4, 5.6],
    "user_id": "user-456",
    "timestamp": "2026-08-29T10:00:00.000Z"
}

# 2. Logged (INFO)
{
    "timestamp": "2026-08-29T10:00:00.010Z",
    "level": "INFO",
    "message": "Prediction request received",
    "request_id": "req-abc-123",
    "feature_count": 3,
    "model_version": "v2.3.1",
    "environment": "production"
}

# 3. Model predicts (latency: 45ms)
# 4. Prediction logged (sample: 10%)
{
    "timestamp": "2026-08-29T10:00:00.055Z",
    "level": "INFO",
    "message": "Prediction successful",
    "request_id": "req-abc-123",
    "inference_time_ms": 45.2,
    "prediction": 0.82,
    "confidence": 0.82,
    "model_version": "v2.3.1"
}

# 5. Metrics updated:
#    - Request count: +1
#    - Latency: added 45.2ms to distribution
#    - Model confidence: added 0.82 to average

# 6. Dashboards update
# 7. If anything fails: Alert!
Your email address will not be published. Required fields are marked *
Comment *
Name *
Email *
Website
Save my name, email, and website in this browser for the next time I comment.